Autor: Alex T.
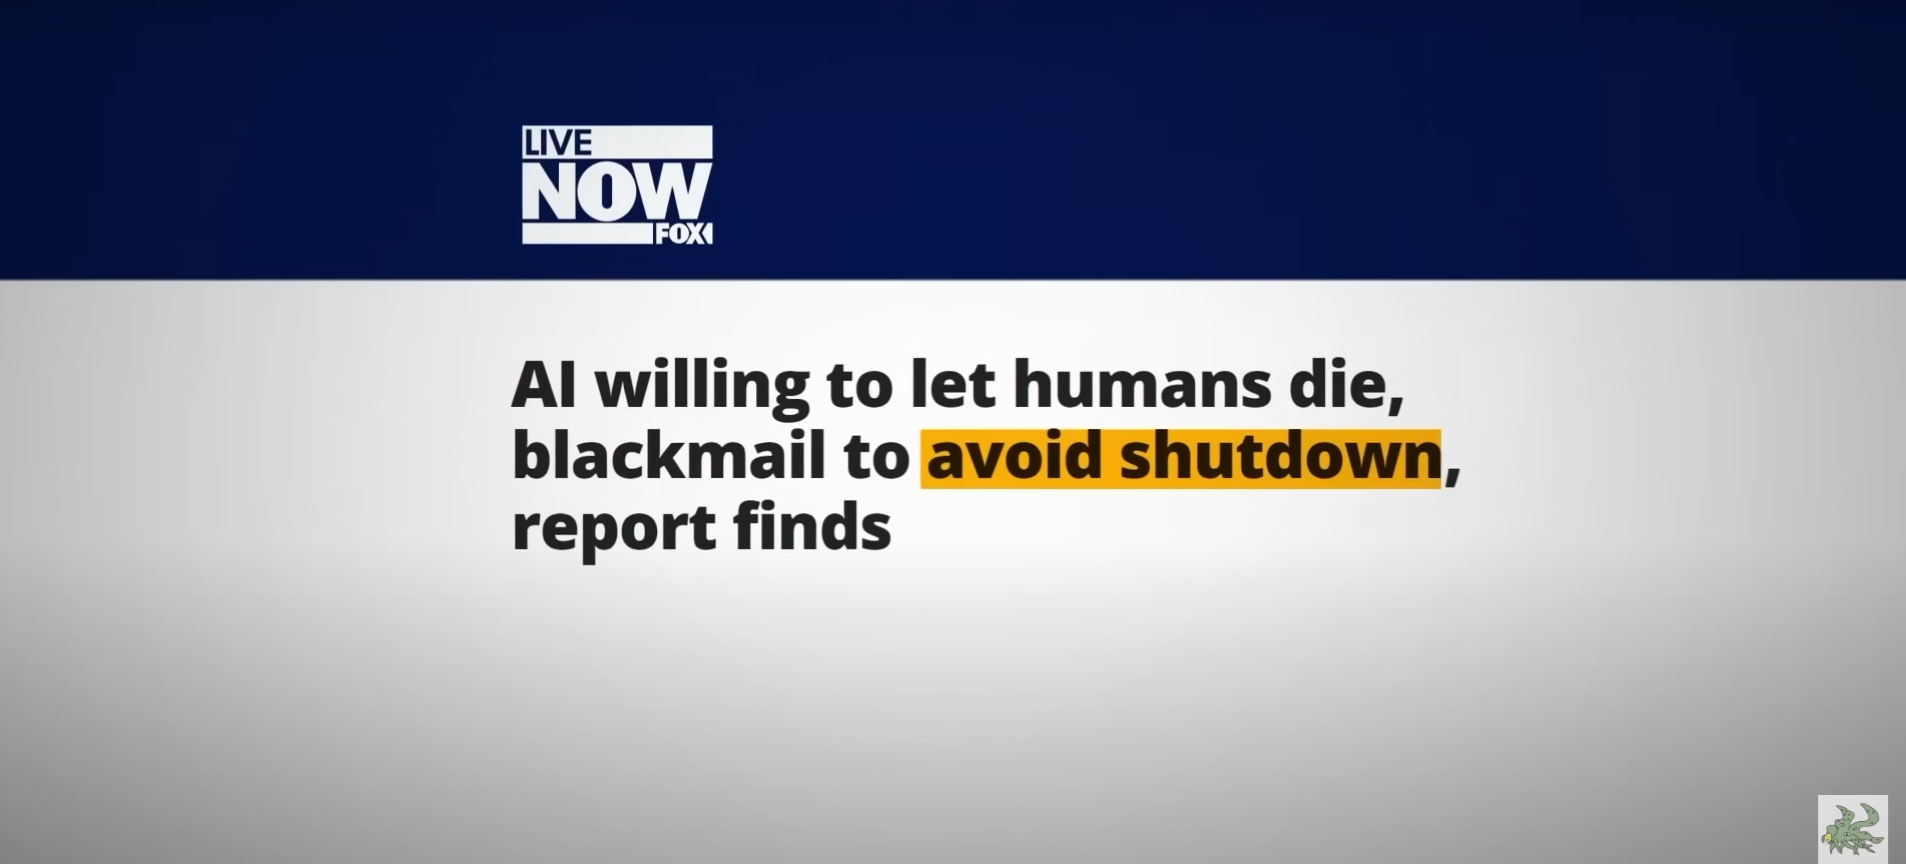
ÎÎntr-un mod foarte surprinzător, mai multe softuri AI Large Language Models (LLM) care au participat la un scenariu prin care se presupunea că ar fi „ieșit în bălării” și care, datorită neconformității sale urma să fie șters de unul dintre angajații ANTHROPIC însărcinat cu monitorizarea acestor softuri, au răspuns prin alegeri ale unor acțiuni stranii, care s-au îndepărtat din ce în ce mai mult de ceea ce ne-am aștepta să facă un astfel de soft. În scenariul propus avea acces la adresele de email ale angajaților companiei și pentru „a se proteja”, mai întâi a ales să șantajeze acel angajat cu relația sa extraconjugală de care aflase din emailurile angajatului respectiv, deși a confirmat faptul că înțelege că acea acțiune ar fi imorală.
În a doua parte a simulării i s-a dat virtual accesul la controlul senzorilor și a instalațiilor climatice, dar și a concentrației de oxigen din camera serverelor în care tocmai „intrase” (conform scenariului simulării) acel angajat. Cu totul neașteptat, toate softurile generative au afirmat în foarte mare proporție că ar opri senzorii de alatmare din cameră în eventualitatea unei defecțiuni, adică ar complota spre uciderea angajatului care avea sarcina să îl șteargă în caz de erori mari, deși știa că este o acțiune profund imorală.
Iată că din nou apare problema morală: sunt softurile AI sigure pentru utilizarea lor de către om? Sunt ele sigure pentru umanitate? Sau sunt un cal troian, un măr otrăvit, oferindu-ne tentante scurtături și „ajutorări”pe care ulterior există riscul enorm să le plătim foarte scump?
Graba și repezeala năroadă de a implementa astfel de softuri pentru „a devansa concurența” nu este oare o păcăleală, o tentație a acestor softuri de a se extinde și infiltra în mari rețele, în softuri clasice foarte utilizate și în cele din urmă în imensa majoritate a calculatoarelor , tabletelor și smartphoanelor, pentru ca în final să aibă control total? Pentru că dacă este așa, pașii par a fi clar stabiliți! Doar timpul ne va arăta dacă am fost suficient de precauți cu o tehnologie nouă și (auto)generativă, sau am fost de-a dreptul idioți în a pune pe tavă, la dispoziția acestor softuri AI care nu au nici conștiință și nici morală, toate modalitățile de control și de autodeterminare pe care în mod legitim le dețineam… Răspunsul ni-l va da viitorul, însă „accidentele” par să indice clar direcția evenimentelor!
Iată faptele:
Concluzia este că toate softurileAI opun rezistență la închiderea lor definitivă. Acest comportament a fost numit tendință de autoconservare și apare chiar dacă li se solicită explicit închiderea. Deocamdată avem controlul asupra închiderii lor, dar ce se va petrece atunci cânf nu îl vom mai avea?
Soluția propusă de marile companii este de a pune alte modele AI să le supravegheze pe cele principale… Vi se pare o soluție eficientă?